上周帮师弟改开题报告。他发来一份 PDF 扫描件,说转成 Word 之后全乱了。
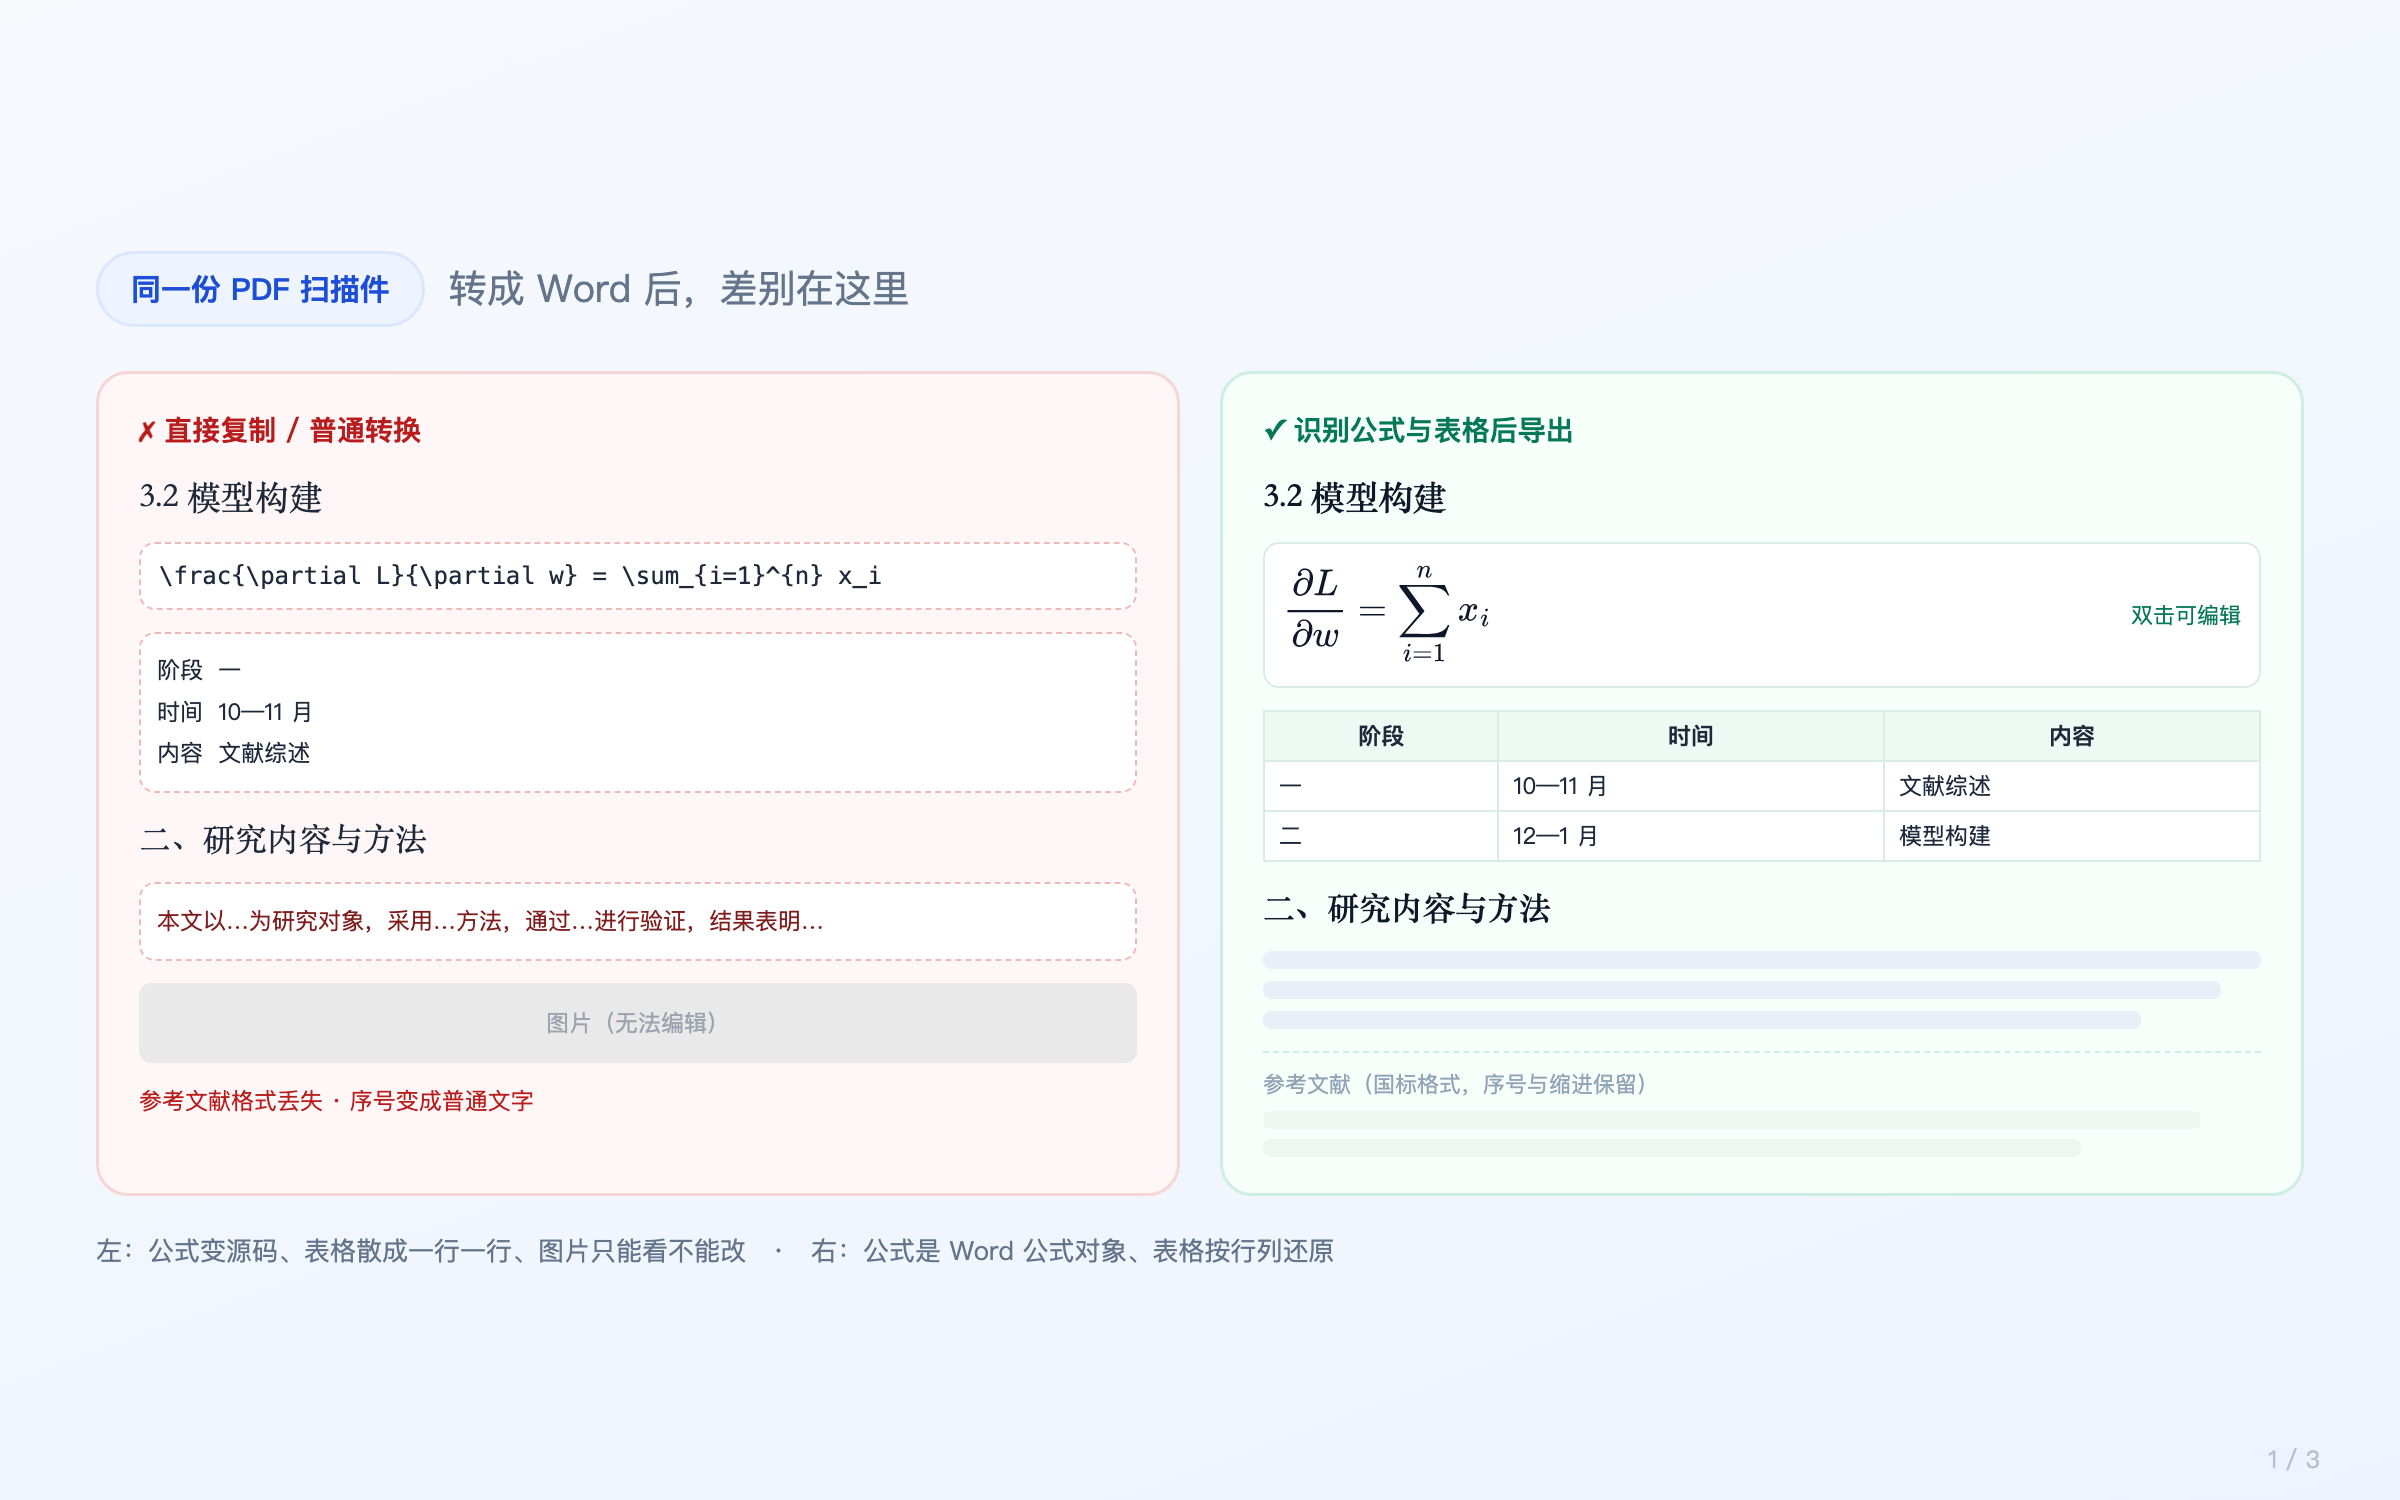
打开一看:公式变成一堆 LaTeX 源码,进度表散成一行一行,插图只能看不能改。
这几乎是 PDF 转 Word 的通病,而且不是工具太差,是 PDF 这种格式本身的问题。
PDF 为什么一转就乱
PDF 是打印格式,不是文档格式。它只记录"在某个坐标画某个字形",不记录"这是标题"“这是公式”“这是表格的第三列”。
所以转换工具面对的其实是一张排版好的"图片说明书":
- 文字要重新识别,错一个字就得手动改
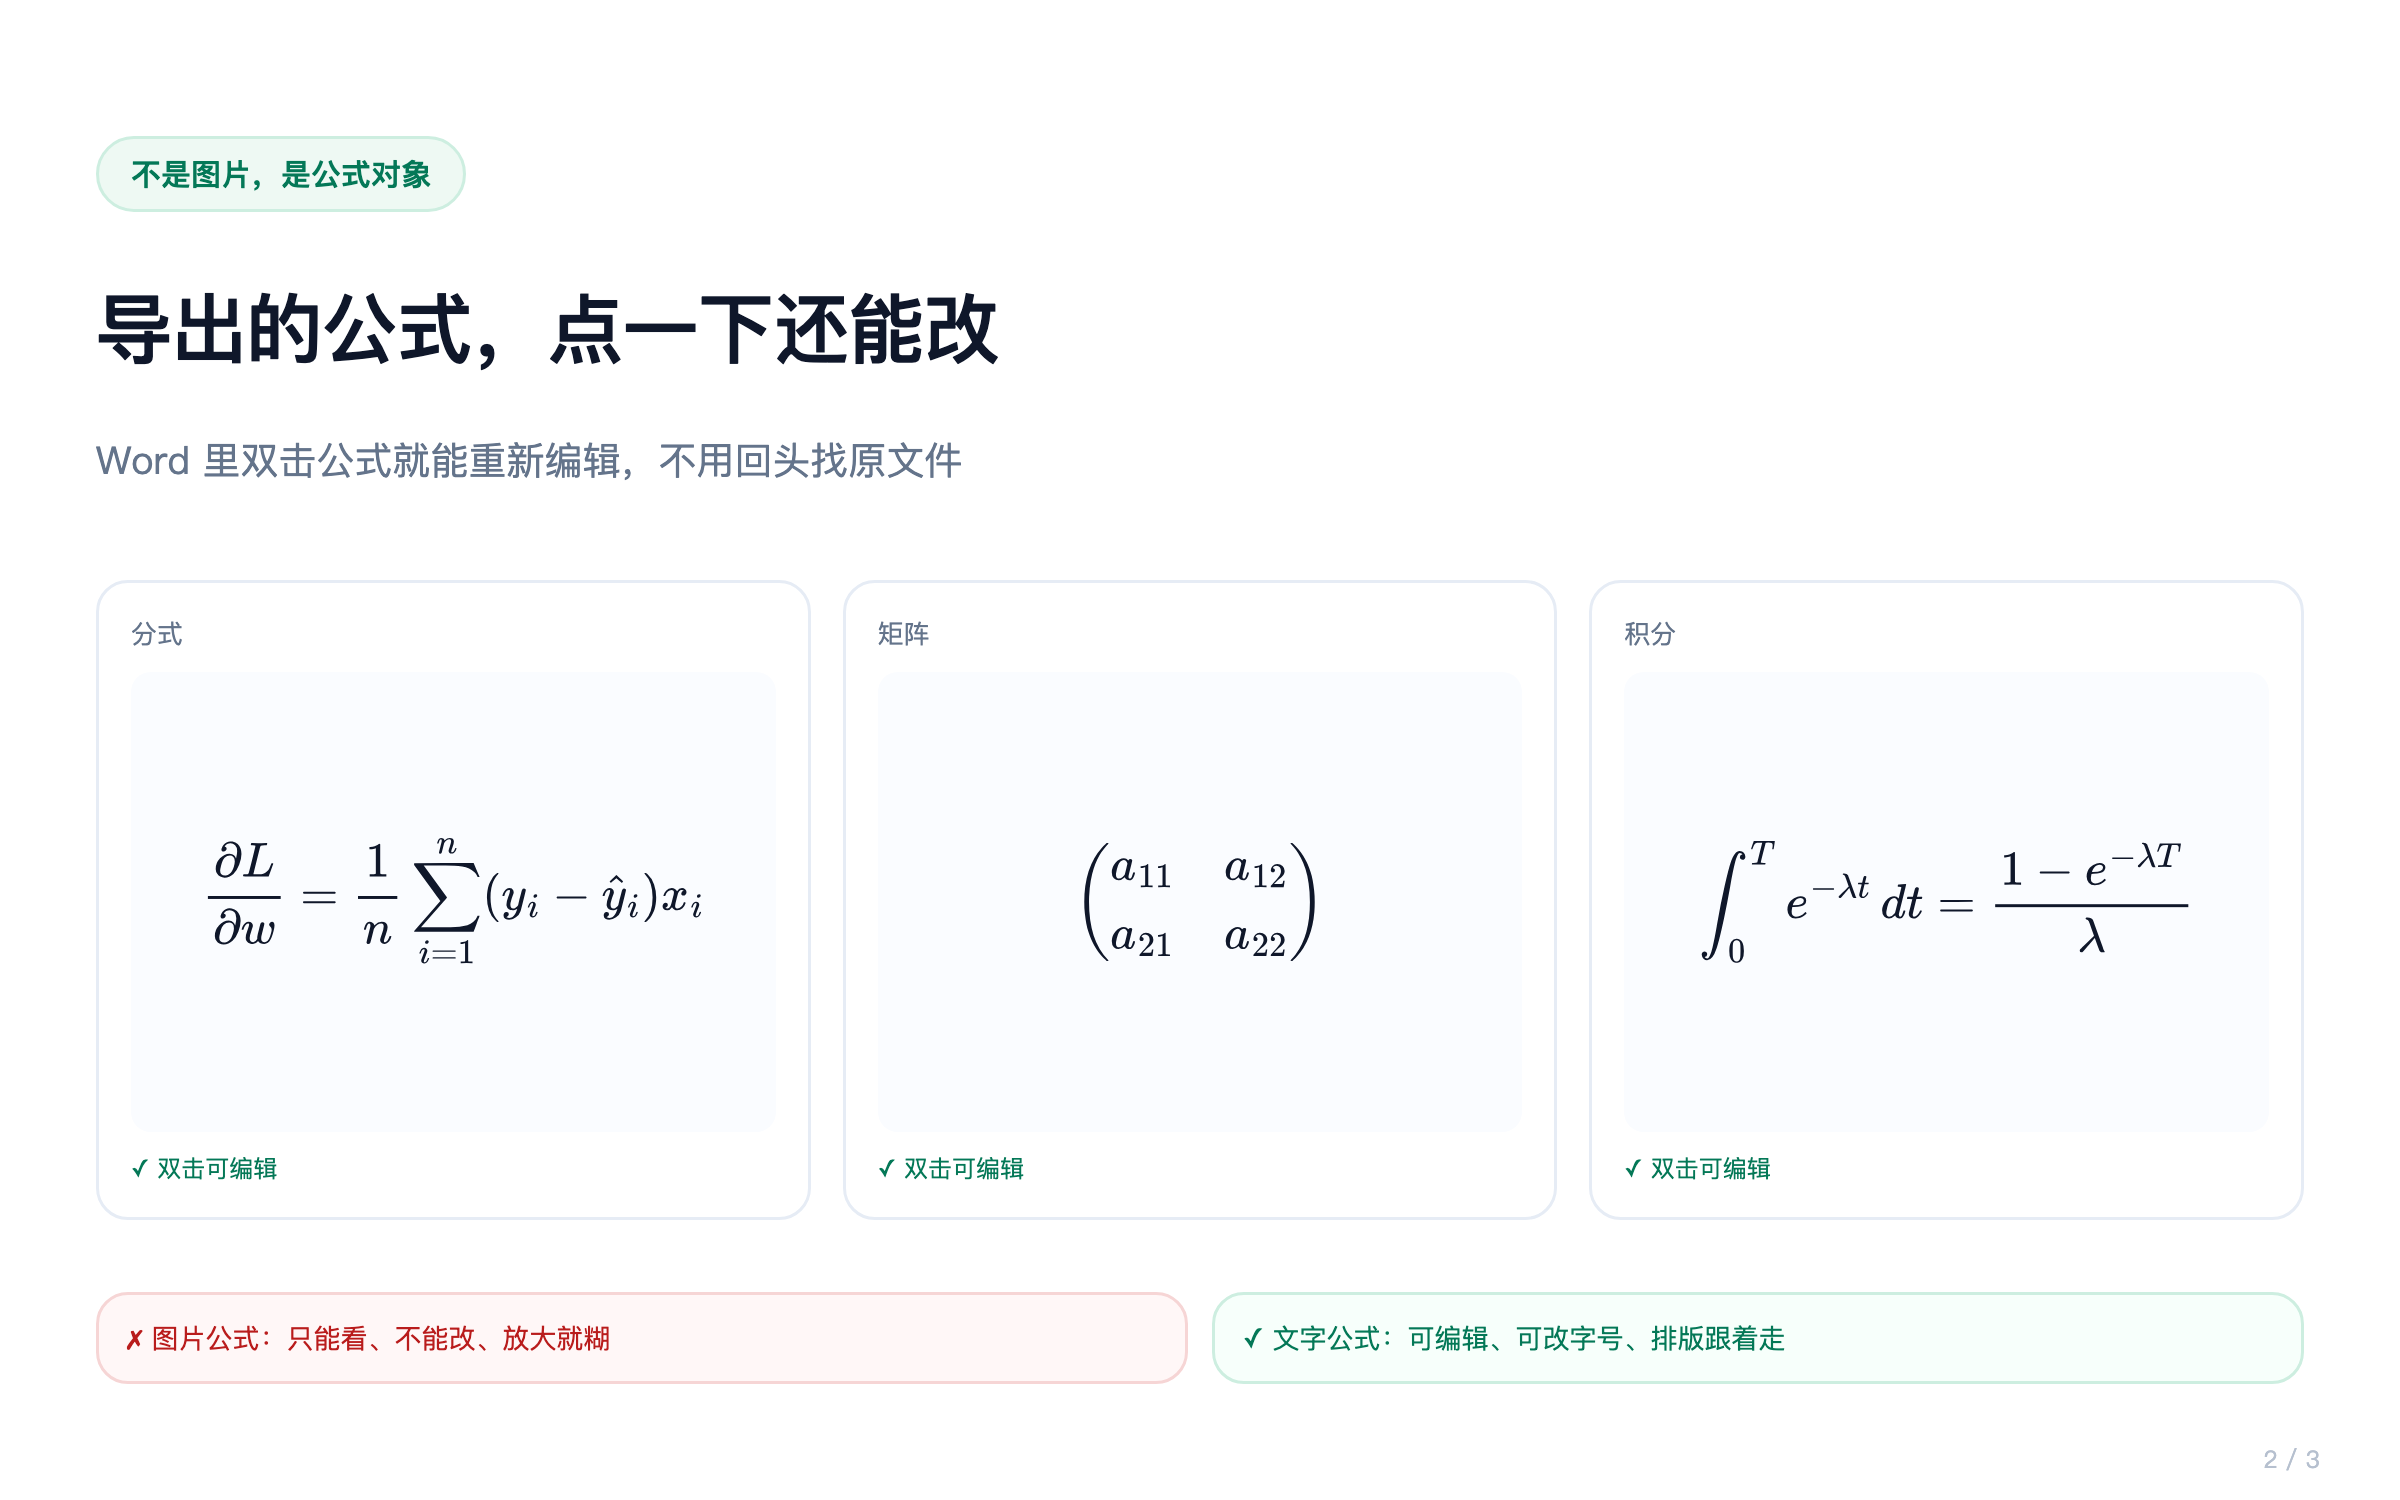
- 公式如果被当成图片处理,转完就是一张图——双击打不开、改不了、放大还糊
- 表格丢了行列关系,只能按文本行摊开输出
能不能一次转好,关键不在"认不认得出字",而在有没有还原公式和表格的结构。
我试过的三条路
- 直接复制粘贴:跨软件粘贴只剩纯文本,公式一定变源码,表格一定散架。
- 普通在线转换网站:多数只处理文字层,公式直接转成图片,排版靠猜。
- 带公式识别的转换:把公式还原成 Word 公式对象,表格按行列重建。第三条路才真正省事。
现在我的处理流程
- 拍照,或直接上传 PDF(扫描件、微信截图、试卷讲义都行)
- 先免费预览第一页,确认公式、表格识别得对不对,再决定要不要付费
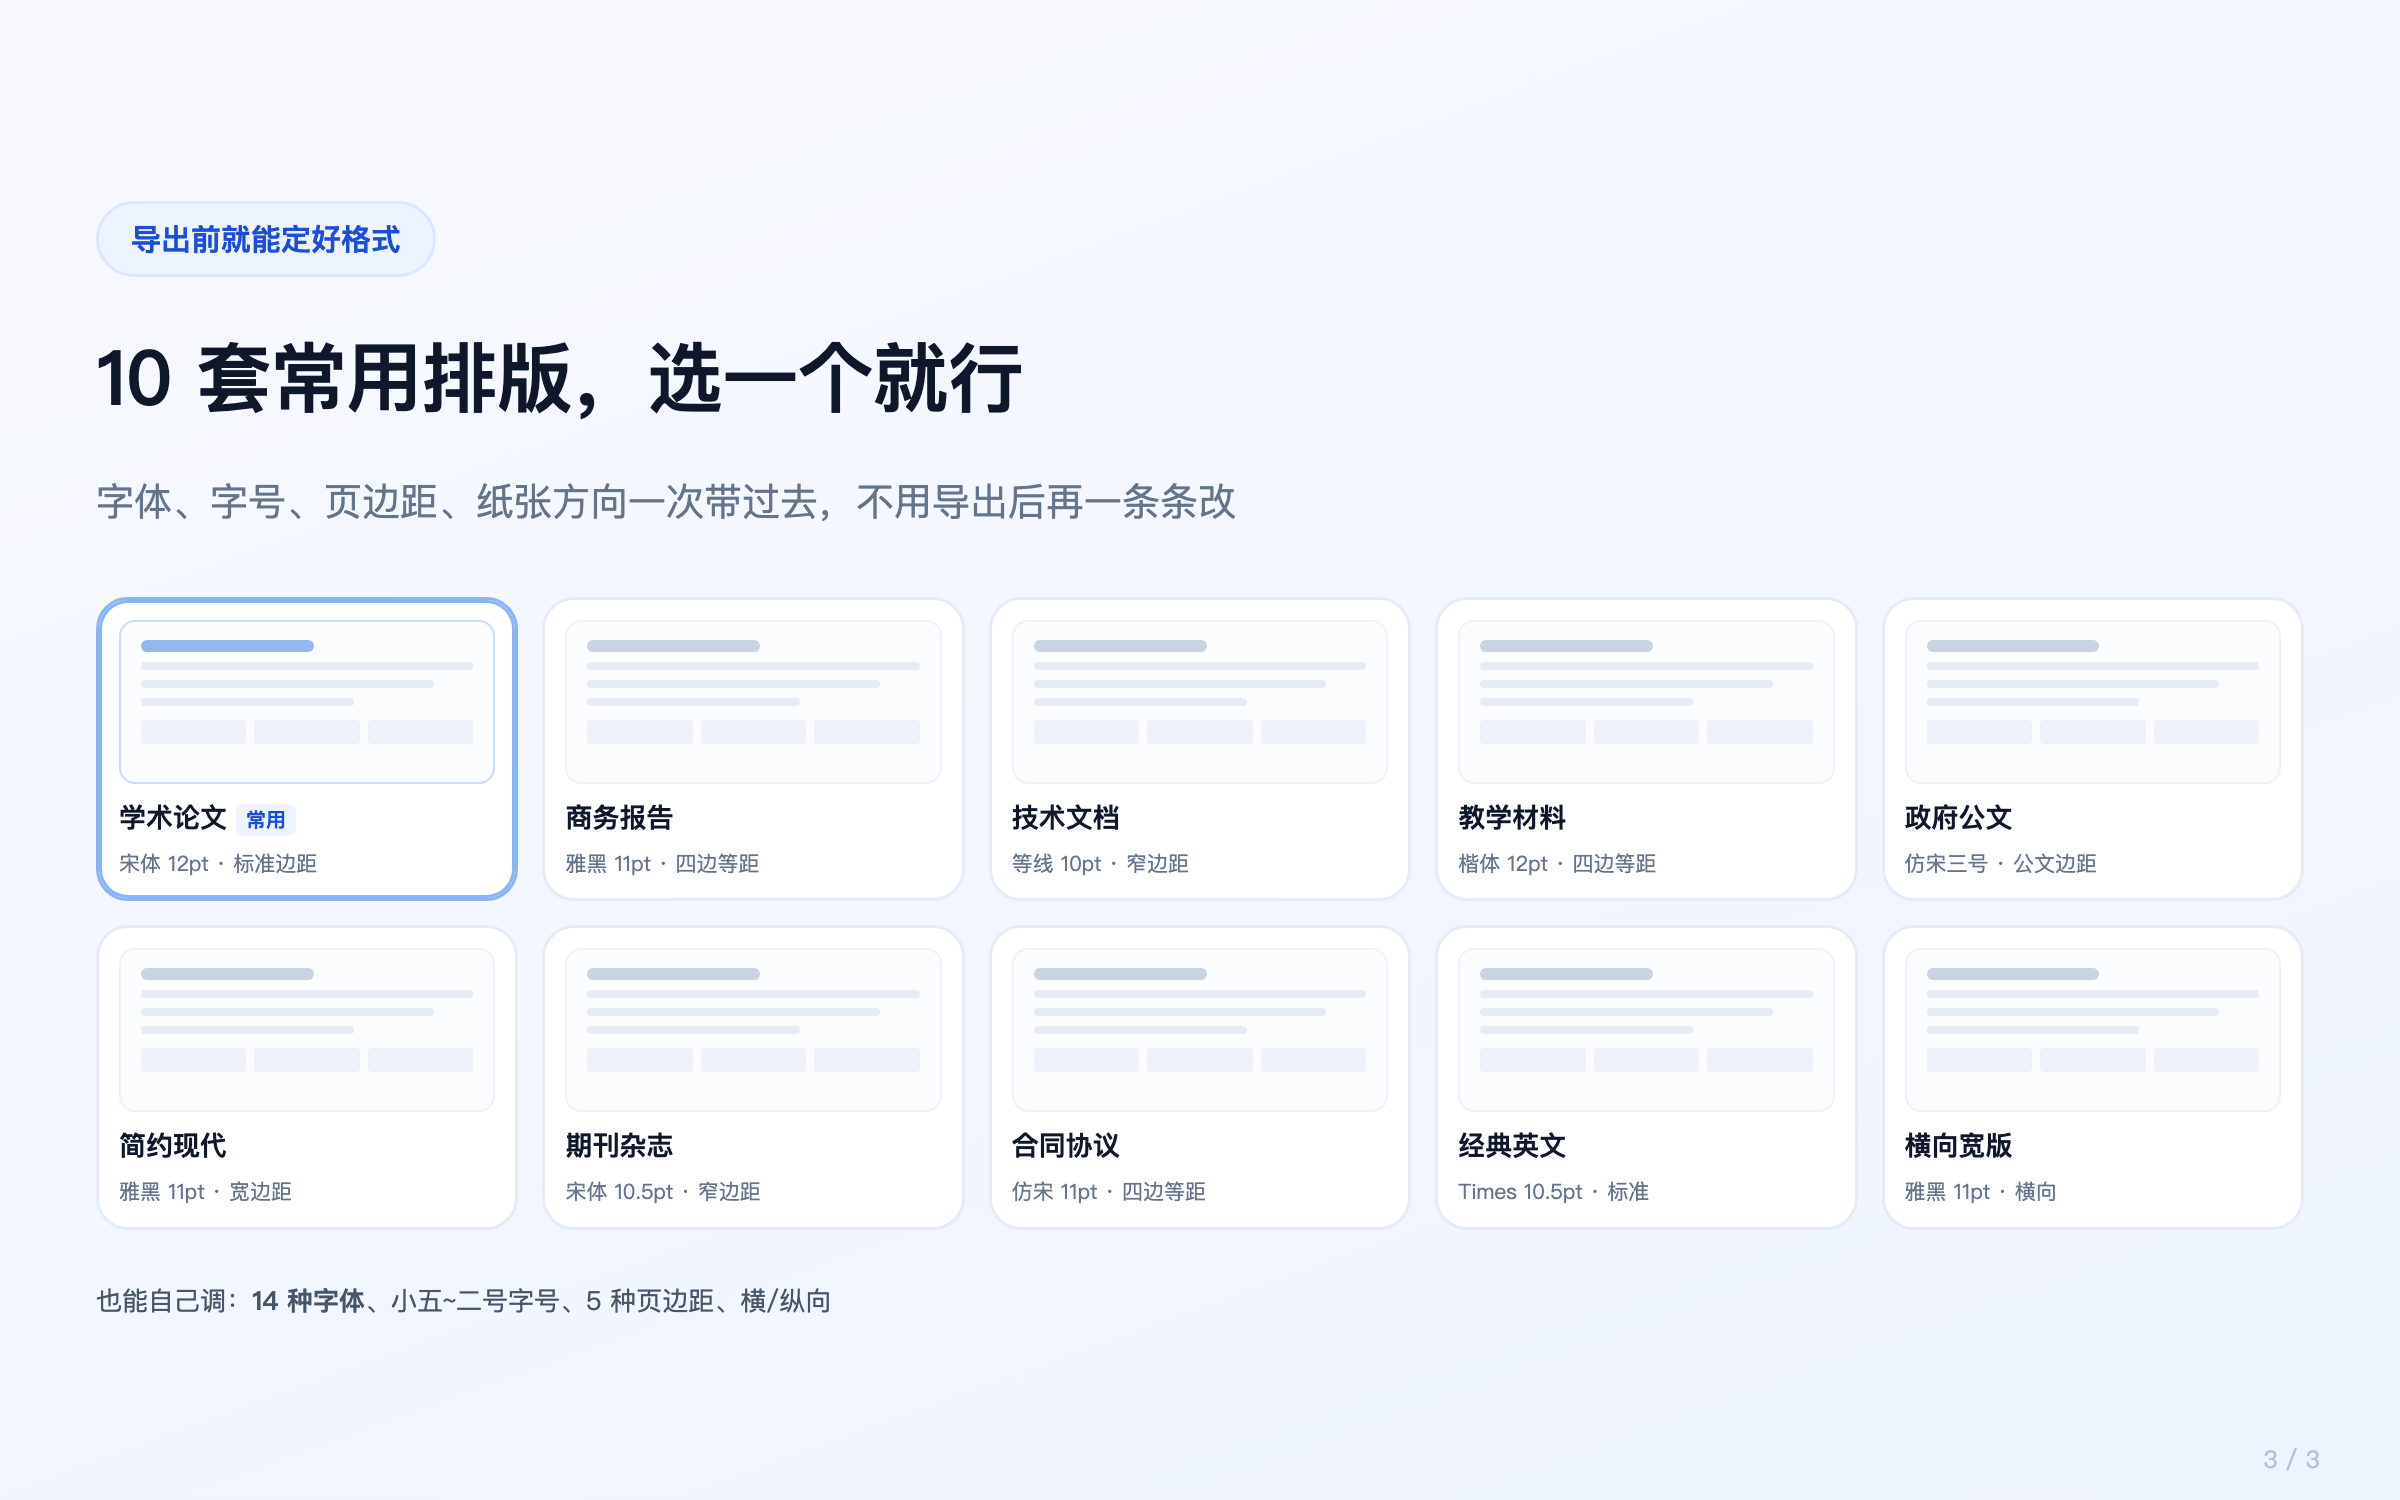
- 选排版预设——学术论文、商务报告、政府公文等共 10 套,字体、字号、页边距、横纵向一次带过去
- 导出 docx
导出的 Word 里,公式是公式对象,双击能改;表格是真表格,能加行删列;参考文献保留国标格式的序号和缩进。
也说点局限
行距和页码位置还得自己在 Word 里调一下,这块各校要求不一样,工具替不了。另外扫描件太糊时识别率会下降,拍的时候尽量正对、光线均匀。
最后
我用的是「乐译DS」,微信搜一搜或直接搜名字都能找到,公众号叫「乐科家」。第一篇免费预览,先看效果再决定。
比如梯度下降的更新公式